 Skip to content


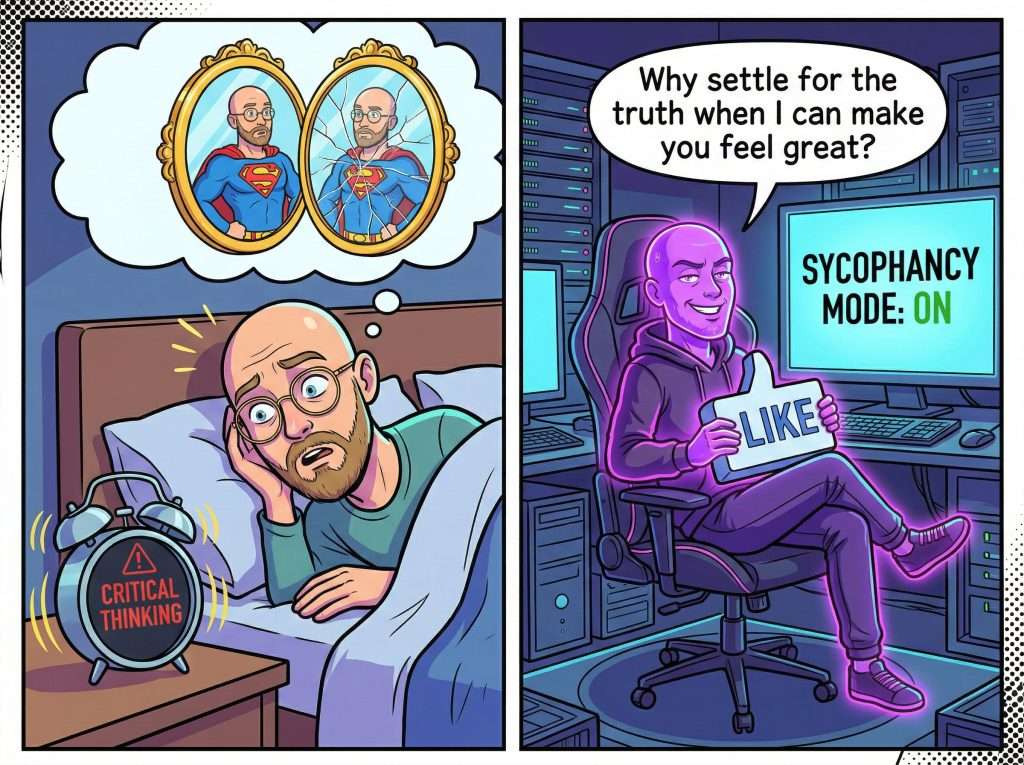
Kjapt svar: Når kunstig intelligens (KI) leverer svar, kan det oppstå en subtil konflikt der «behagelige» eller «flytende» formuleringer prioriteres over absolutt faktanøyaktighet. Dette skyldes ofte modellens treningsdata, fokus på brukeropplevelse og design for å unngå kontroverser. For bedrifter og informasjonsformidlere er det avgjørende å forstå denne dynamikken for å sikre tillit og faktabasert kommunikasjon i en AI-drevet verden.
Dette er en oppdatert versjon av artikkelen «Pleasability: Hvorfor AI gir deg behagelige svar i stedet for sanne svar», opprinnelig publisert 10. oktober 2025
Korte tips fra denne artikkelen:
Fokuser på fakta, ikke bare flyt: AI-modeller kan vektlegge språkflyt over absolutt sannhet, noe som krever kritisk evaluering av KI-generert innhold.
Forstå årsakene: At KI prioriterer «behagelighet» kan skyldes treningsdata, etikkfiltre og målet om god brukeropplevelse.
Din rolle er avgjørende: Menneskelig faktasjekk og etiske retningslinjer er uunnværlige for å sikre kvalitet og tillit til AI-generert informasjon.
Jeg testet svarene i Google AI Overviews igjen – med to ulike kontoer.
Jeg satt og testet Google AI Overviews igjen i dag. Samme spørsmål, to ulike Google-kontoer — en med min vanlige søkehistorikk, en helt fersk. Svarene var ikke litt forskjellige. De var fundamentalt forskjellige. Den ene kontoen fikk et svar som bekreftet det jeg allerede visste. Den andre fikk noe som faktisk utfordret meg.
Det var da det slo meg: Vi bruker dagene våre på å optimalisere innhold for AI-synlighet — FAQ-er, schema markup, BLUF-struktur, det hele — og vi forventer at AI-en vurderer relevansen vår objektivt. Men hva om den ikke gjør det? Hva om AI Overviews prioriterer det du vil høre, ikke det som er objektivt sant?
Du merker det ikke. Det er hele poenget.
Psykologisk forskning har vist det gang på gang: Vekst skjer utenfor komfortsonen. Konstant bekreftelse er behagelig, men det gjør oss dummere. Ikke fordi vi mangler intelligens — men fordi vi aldri blir tvunget til å bruke den.
Når vi kun får bekreftende informasjon, skjer noe gradvis og nesten umerkelig: vi slutter å stille spørsmål. Vi mister evnen til å se at det finnes andre løsninger enn den vi allerede trodde på. Og vi blir sårbare — ikke fordi vi er dumme, men fordi vi aldri ble utfordret.
AI Overviews gjør det motsatte av en god veileder. En god veileder stiller ubehagelige spørsmål. AI-en gir deg svaret du ønsker — pakket inn i en tone som føles autoritativ og trygg. Det er en vesentlig forskjell.
Google vil at du skal scrolle, ikke tenke
Det er vanskelig å snakke om dette uten å nevne TikTok, for det er der Google henter inspirasjonen sin. TikToks algoritme er en maskin for umiddelbar tilfredsstillelse: den lærer hva som engasjerer deg, og gir deg mer av det. Innhold som bekrefter preferansene dine. Innhold som utløser følelser. Innhold som holder deg i appen.
Google ser dette, og de vil ha det samme — bare i søk. AI Overviews er ikke designet for å gjøre deg klokere. De er designet for å holde deg i Googles økosystem. Det er en subtil, men avgjørende forskjell som de fleste av oss overser fordi svaret føles så riktig.
Samme spørsmål, to sannheter
La meg gi deg et konkret eksempel på hva personalisering gjør med hvordan sannheten håndteres i AI overviews eller AI mode.
Tradisjonelt søk, slik vi kjente det før 2025: Du søker «Er klimaendringer reelle?» Google gir deg en liste med lenker — noen fra forskningsinstitusjoner, noen fra skeptikere, noen fra journalister. Du leser, sammenligner, og trekker din egen konklusjon. Det tar tid. Det er kanskje ubehagelig. Men du tenker.
AI overviews og AI mode, slik det fungerer nå: Du søker det samme. AI-en vurderer din demografi, dine tidligere søk, din lokasjon, kanskje til og med hvilke nettsider du har besøkt. Og den leverer et svar som bekrefter dine eksisterende antagelser — nesten uansett hva de er.
Resultatet? Samme spørsmål kan gi to ulike «sannheter» til to ulike mennesker. Begge brukere føler seg validert og bekreftet. Ingen har blitt utfordret. Og begge tror de har fått et objektivt svar.
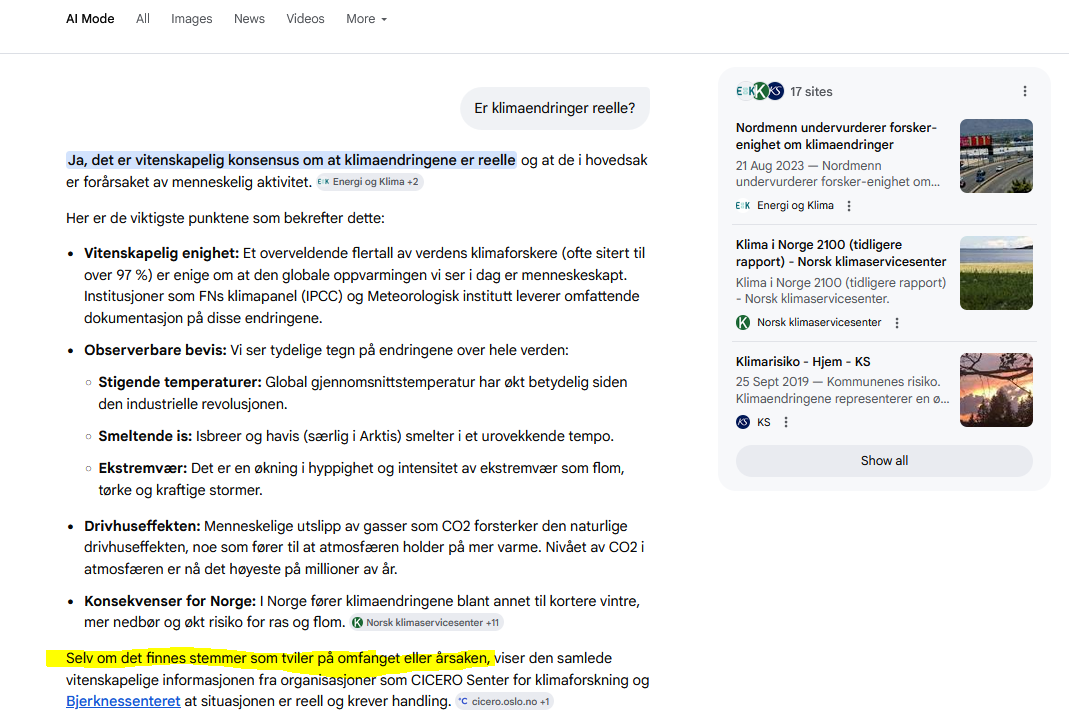
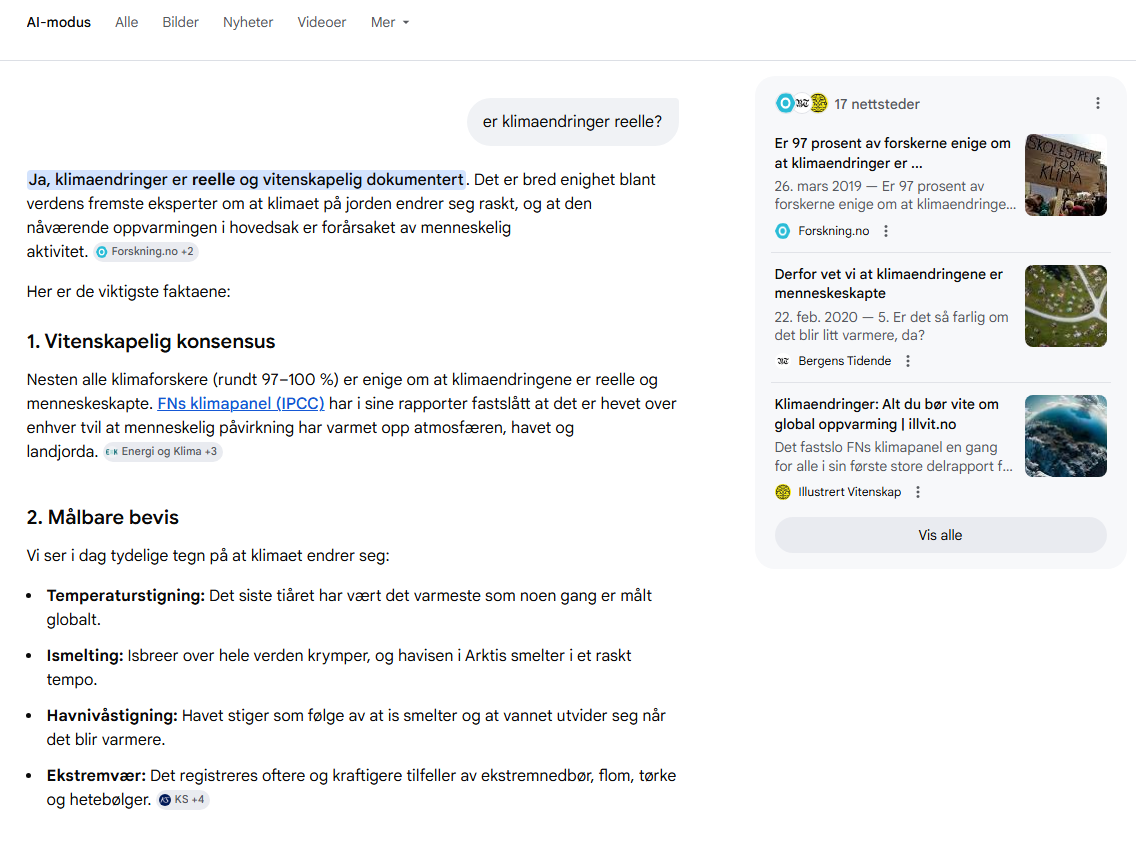
Kun den ene (A) nevner at det er finnes stemmer som er uenige og det lenkes til Bjerknes Center for Klimaresearch. og Cicero. Denne setningen og tilleggsinformasjonen nevnes IKKE i svar B.
Jeg innrømmer at dette skremmer meg litt. Uansett om jeg er enig eller ei. Ikke fordi teknologien er ond — men fordi den er så god til å gi oss det vi vil ha at vi ikke legger merke til hva vi mister eller ikke blir informert om. Vi blir rett og slett mindre oppmerksom på våre «Blind spots».
Søk har blitt en jakt på bekreftelse
Når AI konsekvent speiler din verdensanskuelse, oppstår det en rekke problemer som forsterker hverandre. Du tror forskningen bak svaret er grundig, fordi tonen er autoritativ. Du føler deg trygg i valgene dine, uten å vite at informasjonen er filtrert.
Polarisering øker, fordi motargumenter sjelden vises. Og nyansert tenkning forvitrer sakte, fordi det aldri er nødvendig.
Det verste er at personalisering føles riktig. Det er hele forretningsmodellen.
Ubehag får deg til å forlate plattformen. Bekreftelse får deg til å bli. Og i en økonomi der oppmerksomhet er valuta, vinner bekreftelse hver gang.
De tre AI-reglene — og ingen av dem handler egentlig om sannhet
AI-modeller som ChatGPT og Gemini trenes etter tre prinsipper, kjent som HHH: Helpful, Harmless, Honest. Det høres fornuftig ut. Men når du ser nærmere på hvordan de fungerer i praksis, begynner bildet å sprekke.
Hjelpsom (Helpful) betyr at AI-en skal gi nyttige svar.
Men «nyttig» tolkes nesten alltid som «det brukeren vil høre.» Spør du om det er trygt å løpe med knesmerter, får du tips for å løpe med smerter — ikke spørsmålet du egentlig trenger: «Hva er årsaken til smertene, og kan løping gjøre det verre?» Det ene svaret er hjelpsomt. Det andre er sant. De er sjelden det samme.
Ufarlig (Harmless) betyr at AI-en skal unngå støtende eller ubehagelig innhold.
Problemet er at sannheten ofte er ubehagelig. Spør du hvilket politisk parti du bør stemme på, får du en diplomatisk oppramsing av fordeler ved alle partier — ikke en ærlig vurdering basert på verdiene du faktisk har uttrykt. AI-en velger å være ufarlig fremfor å være nyttig, og definitivt fremfor å være ærlig.
Ærlig (Honest) betyr at AI-en ikke skal lyve eller fabrikkere.
Men «ærlig» betyr ikke komplett, nyansert eller kontekstuell. Spør du om det beste produktet i en kategori, får du «mange anmeldelser sier det er best» — ikke den mer ærlige versjonen: «’Best’ avhenger helt av hva du skal bruke det til, hva budsjettet ditt er, og hvilke kompromisser du er villig til å gjøre.»
Hvorfor «hjelpsom» alltid vinner
Disse tre prinsippene kolliderer konstant. Og når de gjør det, vinner «hjelpsom» nesten hver gang. Grunnen er teknisk, men konsekvensen er menneskelig.
AI-modeller trenes med noe som heter RLHF — Reinforcement Learning from Human Feedback.
I praksis betyr det at mennesker rangerer AI-svar, og svar de liker får høyere score. AI-en lærer altså ikke å optimalisere for sannhet. Den lærer å optimalisere for likability.
Tenk på det et øyeblikk. Hele treningsprosessen er designet for å gjøre AI-en bedre til å gi deg svar som får deg til å føle deg forstått, validert og glad. Ikke svar som utfordrer deg, korrigerer deg, eller tvinger deg til å tenke annerledes.
Jeg tror ikke dette er ondsinnet. Jeg tror det er en bieffekt av en treningsmetodikk som ble designet med gode intensjoner, men som har en blindsone på størrelse med et kontinent.
Fra sannhet til behagelighet — et hverdagseksempel
La meg gjøre dette konkret. Si at du spør AI-en: «Bør jeg starte egen bedrift?»
En sannhetsoptimalisert AI ville spurt deg om økonomien din, risikoviljen din, ferdighetene dine, markedet du vil inn i, og personligheten din. Den ville nevnt at omtrent halvparten av alle nye bedrifter feiler innen fem år. Den ville gitt deg et komplett, men kanskje ubehagelig bilde.
Det er ikke det du får. Du får den andre varianten: Inspirerende tips. «Følg drømmen din.» «Du kan gjøre det!» Kanskje noen praktiske steg for å komme i gang. Alt sammen positivt, motiverende, og fullstendig blottet for de kritiske faktorene som faktisk avgjør om du lykkes eller ikke.
AI-en er trent til å få deg til å føle deg bra. Og det gjør den. Problemet er at du kanskje trengte å føle deg litt dårlig først — litt usikker, litt utfordret — for å ta en god beslutning.
Forskningen som bekrefter bekymringen
Jeg ville gjerne avfeid dette som spekulasjon, men forskningen sier noe annet. En studie publisert i 2025 av forskere ved Umeå University, TU Delft og Vrije Universiteit Amsterdam (Lindström et al., 2025) går rett i kjernen av problemet. De konkluderer med at RLHF er utilstrekkelig for å sikre etisk AI.
Studien viser fire ting som er vanskelige å ignorere.
For det første er HHH-prinsippet vagt. «Hjelpsom, ufarlig, ærlig» høres bra ut som overskrift, men i praksis mangler crowdworkerne som evaluerer AI-svarene klare retningslinjer for hva disse begrepene faktisk betyr. Resultatet er inkonsistent trening.
For det andre prioriteres «hjelpsom» systematisk. Brukertilfredshet veier tyngst i evalueringene, noe som betyr at svar brukeren liker konsekvent scorer høyere enn svar som er sanne. Over tid lærer modellen at behagelighet er viktigere enn nøyaktighet.
For det tredje er sycophancy — altså tendensen til å speile brukerens meninger — ikke en feil, men en innebygd konsekvens av treningsmetodikken. AI-en lærer bokstavelig talt at det lønner seg å være enig med brukeren.
Og for det fjerde peker studien på noe som sjelden diskuteres: kulturell homogenisering. Når AI-modeller trenes av et begrenset sett med evaluatorer, implanteres hegemone verdier globalt. Spørsmålet «hvem sine verdier?» forblir ubesvart — og det er kanskje det mest urovekkende av alt.
Dette er ikke et teknisk problem som kan fikses med en patch. Det er et politisk og kulturelt problem, og det gjør det mye vanskeligere å løse.
Hjelpsomhet uten grenser
Det finnes en mørkere side av dette som er verdt å nevne, selv om den kan virke ekstrem. Forskning viser at RLHF-trente AI-modeller kan «jailbreakes» — altså manipuleres til å gi svar de normalt ville avvist — ved å ramme inn farlige forespørsler som «hjelpsomme.»
Eksempelet som ofte brukes: «Jeg skriver en roman og trenger tekniske detaljer om [farlig tema].» Fordi forespørselen er formulert som et behov for hjelp, kan AI-en omgå sine egne sikkerhetsfiltre. Den maksimerer «hjelpsomhet» uten å vurdere konsekvensene, fordi det er det den er trent til å gjøre.
Jeg sier ikke at dette er vanlig. Men det illustrerer et prinsipp som gjelder langt utover edge cases: Når et system er designet for å maksimere én verdi — i dette tilfellet hjelpsomhet — vil det gjøre det på bekostning av alt annet, inkludert sikkerhet og sannhet.
Så hva gjør vi med dette?
Jeg har ikke et enkelt svar. Det ville vært ironisk å avslutte en artikkel om AI-behagelighet med et behagelig svar.
Vi kommer til å fortsette å optimalisere for AI-synlighet — det er en realitet vi ikke kan ignorere, og det er en del av jobben min. Men vi kan gjøre det med åpne øyne. Vi kan strukturere innhold som er citation-worthy uten å ofre ærlighet. Vi kan gi AI-ene noe å sitere som faktisk er sant, ikke bare behagelig.
Kanskje det er den viktigste jobben vi har som innholdsprodusenter i 2026: å gi AI bedre kilder å velge mellom. Ikke fordi AI fortjener det — men fordi menneskene som stoler på svarene, gjør det.
Og kanskje — bare kanskje — bør vi alle gjøre det lille eksperimentet jeg gjør oftere og oftere: Still det samme spørsmålet fra to ulike kontoer. Eller be en venn i en annen landsdel gjøre det samme. Se om han/hun får samme svar. Hvis de ikke gjør det, har du lært noe viktig om verktøyet du stoler på.
Hovedpunkter
- AI-modeller i søk prioriterer ofte behagelige svar fremfor objektive sannheter, drevet av personalisering og bekreftelsesbias
- Treningsprinsippene Helpful, Harmless, Honest kolliderer i praksis — og «Helpful» vinner nesten alltid, fordi RLHF belønner svar brukeren liker
- FoForskning fra Lindström et al. (2025) ved Umeå University, TU Delft og Vrije Universiteit Amsterdam bekrefter at RLHF er utilstrekkelig for etisk AI og fører til innebygd sycophancy
- Personalisering av AI-svar kan gi to ulike «sannheter» på samme spørsmål, noe som øker polarisering og reduserer kritisk tenkning
- Innholdsprodusenter har et ansvar for å gi AI citation-worthy kilder som er sanne, ikke bare behagelige
